Segmentation d'images : approche classique ou apprentissage
Ce projet, réalisé avec Marcos Levi Pinto Sousa à l’ITA, compare deux approches très différentes de la segmentation sémantique binaire : l’algorithme classique GrabCut, fondé sur la minimisation d’une énergie, et un U-Net léger implémenté depuis zéro avec PyTorch.
Les deux méthodes ont été évaluées sur le même sous-ensemble de validation de l’Oxford-IIIT Pet Dataset. L’objectif n’était pas seulement d’identifier la méthode produisant les meilleurs masques, mais aussi de comprendre le coût de cette amélioration en temps d’entraînement, en état du modèle et en ressources de calcul.
Formellement, les deux méthodes estiment une fonction d’étiquetage binaire
GrabCut construit ce masque image par image en ajustant un modèle probabiliste de couleur et en minimisant une énergie. Le U-Net apprend au contraire les paramètres d’une fonction non linéaire à partir d’exemples annotés, puis applique directement cette fonction lors de l’inférence.
Résultats principaux
Performance sur le jeu de validation
Moyenne ± écart-type calculés image par image. Une valeur plus élevée est meilleure.
Précision par pixel
Intersection over Union
Le modèle appris améliore la précision par pixel de 11 points et l’IoU de 16 points. Son écart-type plus faible indique également un comportement plus régulier sur les images de validation. GrabCut ne demande cependant ni phase d’entraînement ni modèle sauvegardé, ce qui reste un avantage important sur des systèmes contraints.
Relativement à GrabCut, le gain atteint environ en précision par pixel et en IoU. Le gain plus important en IoU montre que le réseau ne se contente pas de mieux classer le fond : il reconstruit plus fidèlement la région correspondant à l’animal.
Construire une tâche commune
L’Oxford-IIIT Pet Dataset contient des images de 37 races de chats et de chiens accompagnées d’annotations par pixel. Pour cette expérience, chaque image et chaque masque ont été redimensionnés à , puis l’annotation à trois régions a été convertie en une cible binaire animal-fond.
img = self.resize(img)
img = self.to_tensor(img)

mask = cv2.resize(
    np.array(mask, dtype=np.uint8),
    (self.image_size, self.image_size),
    interpolation=cv2.INTER_NEAREST,
)
mask = (mask != 2).astype(np.float32)
L’interpolation bilinéaire convient aux images RGB, mais elle créerait des étiquettes intermédiaires invalides dans un masque. L’interpolation par plus proche voisin conserve au contraire les classes discrètes. Le chargeur transforme finalement chaque exemple en un tenseur RGB et une cible binaire à un canal.
Segmentation classique avec GrabCut
Pour les couleurs , GrabCut attribue à chaque pixel une étiquette et une composante gaussienne . Le premier plan et l’arrière-plan sont décrits par deux mélanges de Gaussiennes de paramètres . L’énergie à minimiser est
Le coût de données est la log-vraisemblance négative du pixel sous la composante choisie. Un terme de régularisation pénalise en parallèle les frontières entre voisins de couleurs proches :
Lorsque les paramètres des mélanges sont fixés, cette énergie binaire se résout par une coupe minimale -. GrabCut alterne cette coupe avec une nouvelle estimation des composantes et de leurs paramètres jusqu’à stabilisation du masque.
L’implémentation initialise GrabCut avec une boîte englobante calculée à partir du masque de référence et élargie de dix pixels :
def get_bbox_from_mask(mask, pad=10):
    ys, xs = np.where(mask)
    height, width = mask.shape

    y0, y1 = ys.min(), ys.max()
    x0, x1 = xs.min(), xs.max()

    return (
        max(x0 - pad, 0),
        max(y0 - pad, 0),
        min(x1 + pad, width - 1) - max(x0 - pad, 0),
        min(y1 + pad, height - 1) - max(y0 - pad, 0),
    )
Cette initialisation fournit une localisation approximative de l’objet sans révéler sa segmentation complète. OpenCV réalise ensuite cinq itérations et conserve les pixels classés comme premier plan certain ou probable :
cv2.grabCut(
    img_bgr,
    mask,
    rect,
    bgd,
    fgd,
    iterCount=5,
    mode=cv2.GC_INIT_WITH_RECT,
)

result = (mask == cv2.GC_FGD) | (mask == cv2.GC_PR_FGD)
Une ouverture morphologique suivie d’une fermeture avec un noyau supprime le bruit isolé et comble les petites lacunes du masque binaire.
La boîte est calculée depuis l’annotation de référence. GrabCut bénéficie donc d’une information de localisation qui devrait provenir d’un utilisateur ou d’un détecteur dans un système réel. L’expérience ne lui révèle pas la frontière finale, mais elle n’évalue pas non plus une découverte entièrement automatique de l’objet.
Un U-Net compact
L’approche apprise repose sur un encoder-decoder volontairement réduit. Trois étages d’encodage font passer le nombre de canaux de 16 à 64 tout en diminuant la résolution spatiale. Deux étages de décodage restaurent la résolution initiale et concatènent les activations de l’encodeur au moyen de connexions de saut.
class UNet(nn.Module):
    def __init__(self, in_channels=3, out_channels=1):
        super().__init__()
        self.enc1 = DoubleConv(in_channels, 16)
        self.enc2 = DownSample(16, 32)
        self.enc3 = DownSample(32, 64)

        self.up3 = UpSample(64, 32, 32)
        self.up2 = UpSample(32, 16, 16)

        self.outc = nn.Conv2d(16, out_channels, kernel_size=1)
        self.activation = nn.Sigmoid()
La skip connection constitue le détail essentiel. La réduction de résolution donne au réseau un contexte plus large, mais supprime des informations spatiales fines. La concaténation de la carte d’activation correspondante de l’encodeur dans le décodeur permet de récupérer la précision des contours :
Si désigne l’activation de l’encodeur à l’échelle et la représentation plus grossière du décodeur, une étape de décodage s’écrit abstraitement
Le décodeur réunit ainsi le contexte sémantique du bottleneck et les détails spatiaux de haute résolution produits par l’encodeur.
def forward(self, x1, x2):
    x1 = self.up(x1)
    if x1.shape[-2:] != x2.shape[-2:]:
        x1 = F.interpolate(x1, size=x2.shape[-2:])

    return self.conv(torch.cat([x2, x1], dim=1))
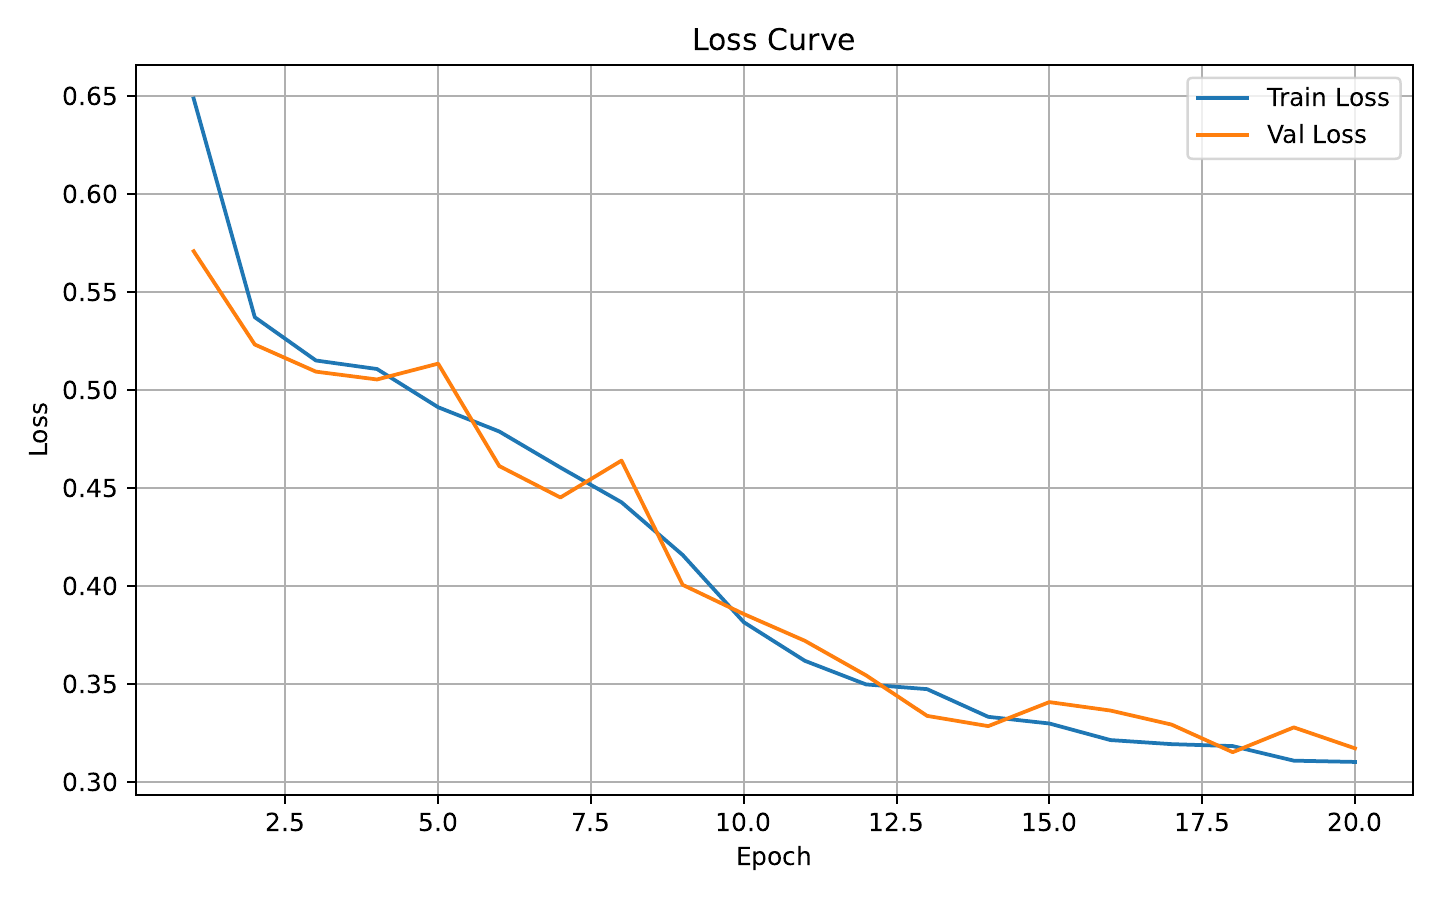
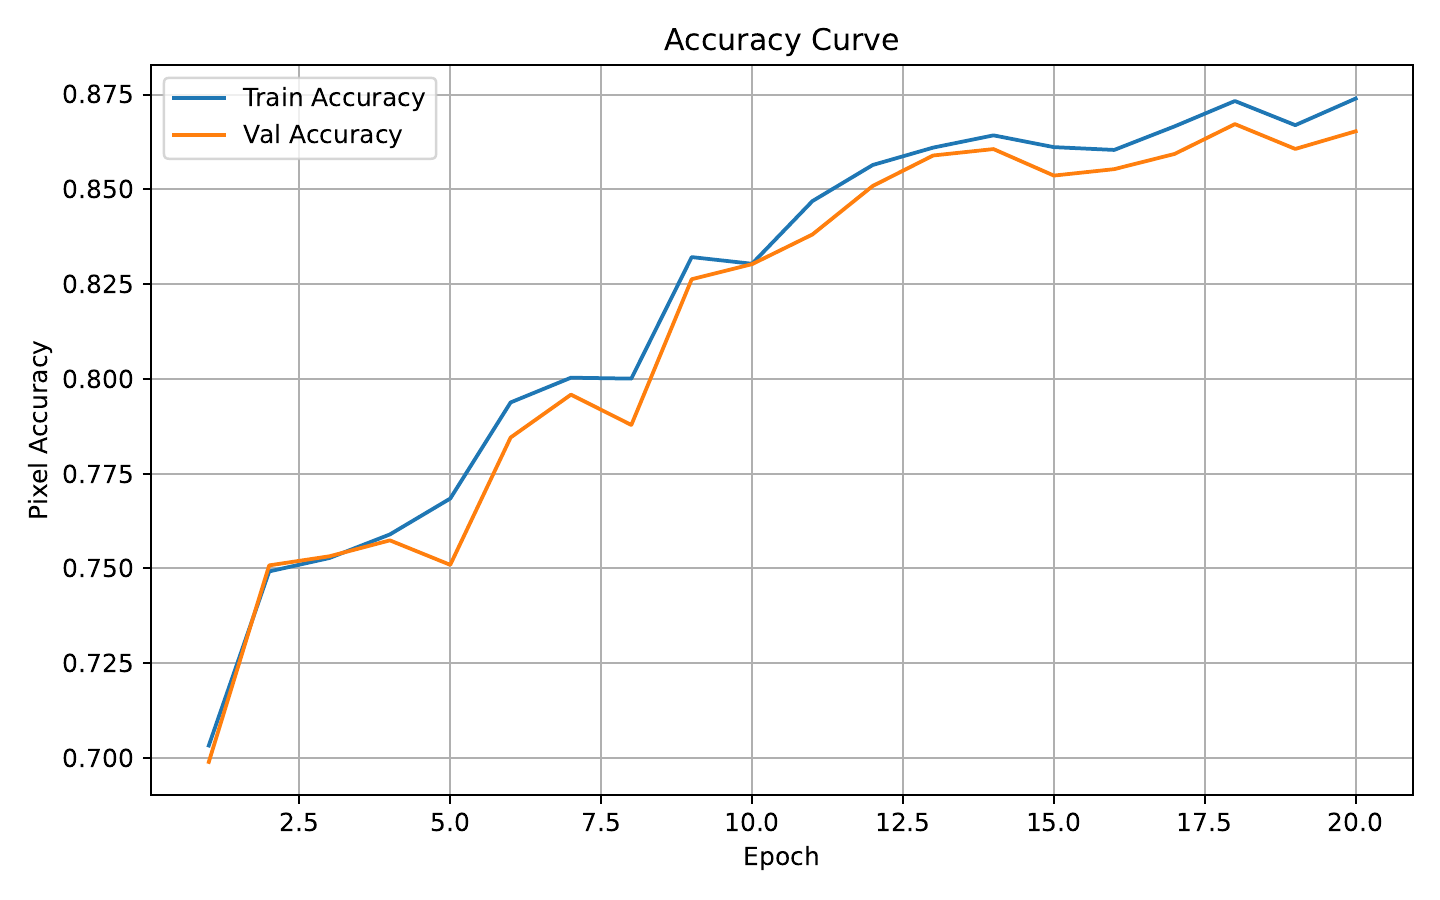
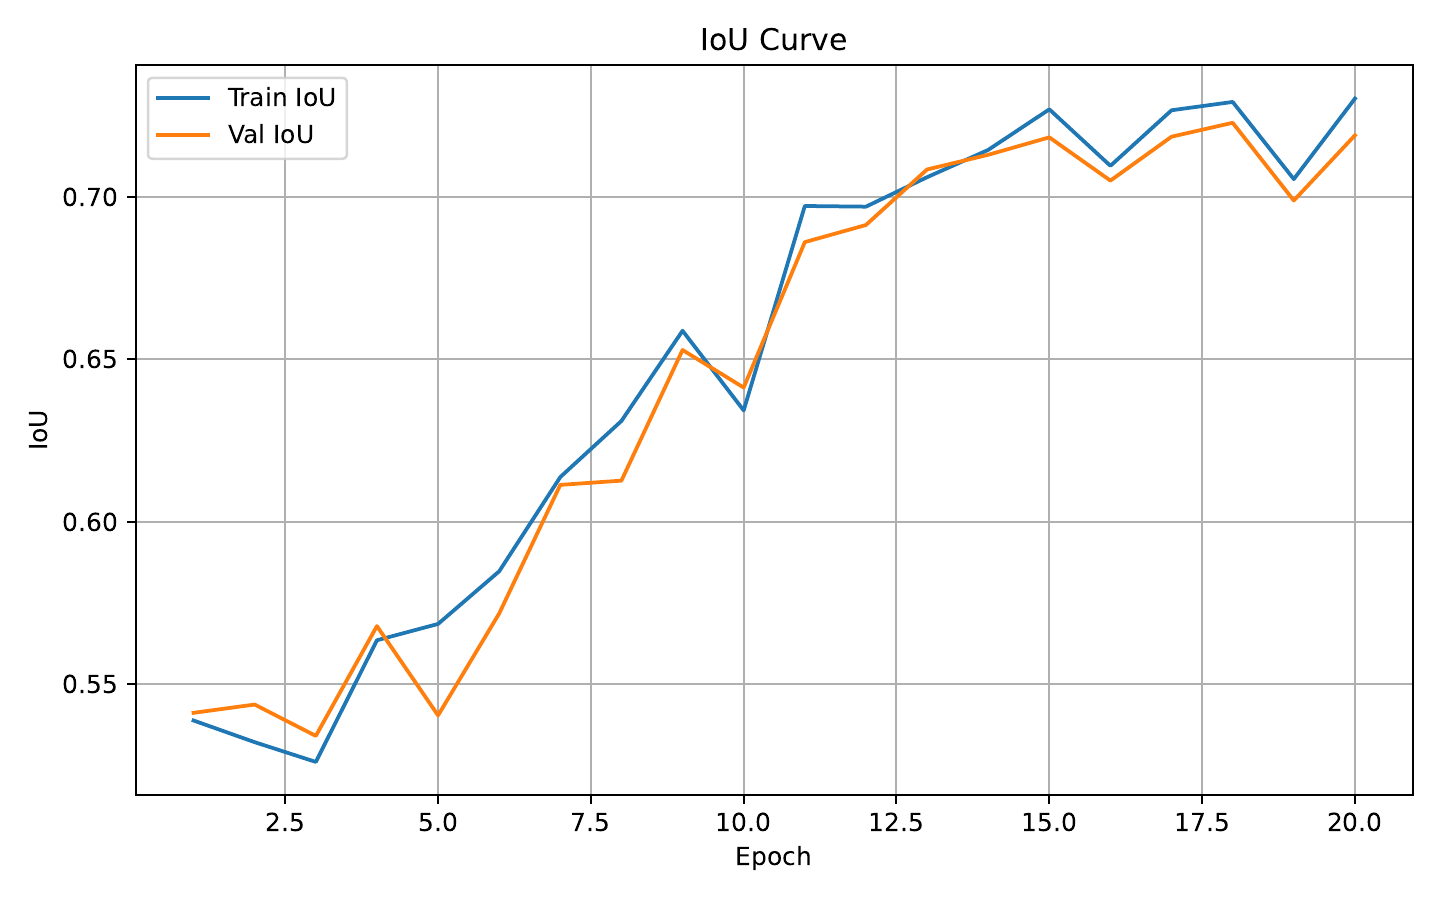
Le modèle a été entraîné pendant 20 époques avec Adam, un taux d’apprentissage de et l’entropie croisée binaire :
Convergence au cours des 20 époques
Les courbes d’entraînement et de validation restent proches pendant que la perte diminue et que les deux métriques progressent.
Lors de l’inférence, les probabilités produites par la sigmoïde sont seuillées à pour obtenir un masque binaire.
Mesurer le recouvrement, pas seulement les pixels corrects
La précision par pixel et l’intersection sur l’union sont définies par
La première métrique peut être optimiste lorsque le fond domine l’image. L’IoU ignore les vrais négatifs et mesure plus directement le recouvrement de l’objet. L’évaluation calcule les deux métriques image par image, puis étudie leur moyenne, leur dispersion et la forme de leur distribution.
def compute_iou(preds, masks, eps=1e-7):
    intersection = (preds * masks).sum()
    union = preds.sum() + masks.sum() - intersection
    return ((intersection + eps) / (union + eps)).item()
Interprétation des distributions
Distribution des scores de validation
Les histogrammes révèlent ce que les moyennes masquent : GrabCut présente davantage d’échecs sévères, surtout en IoU.
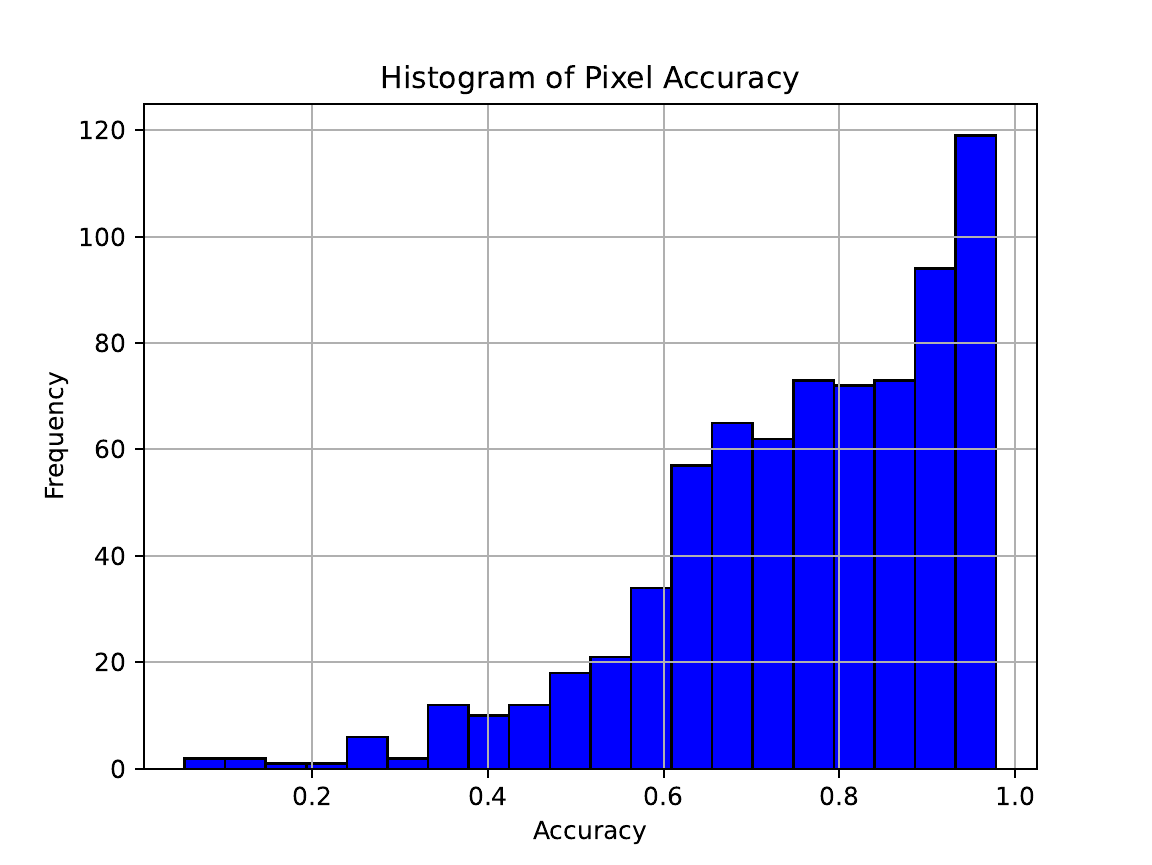
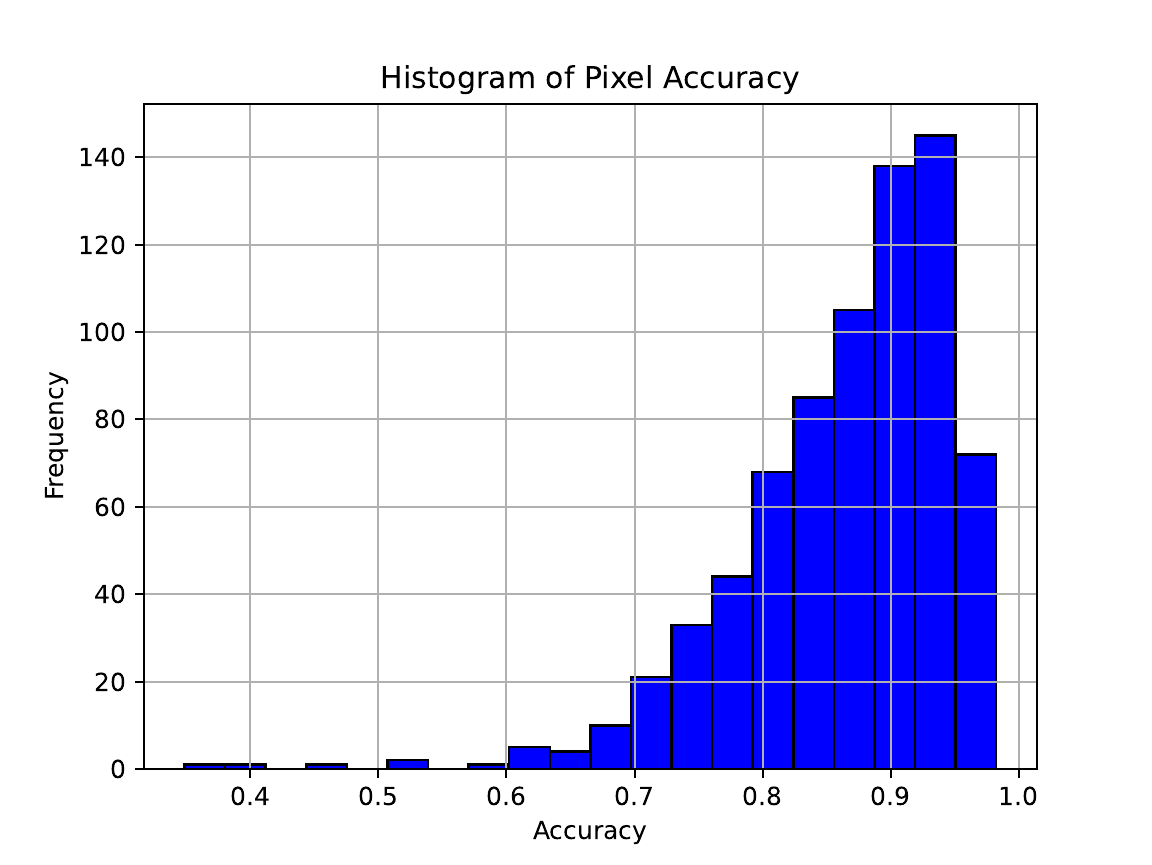
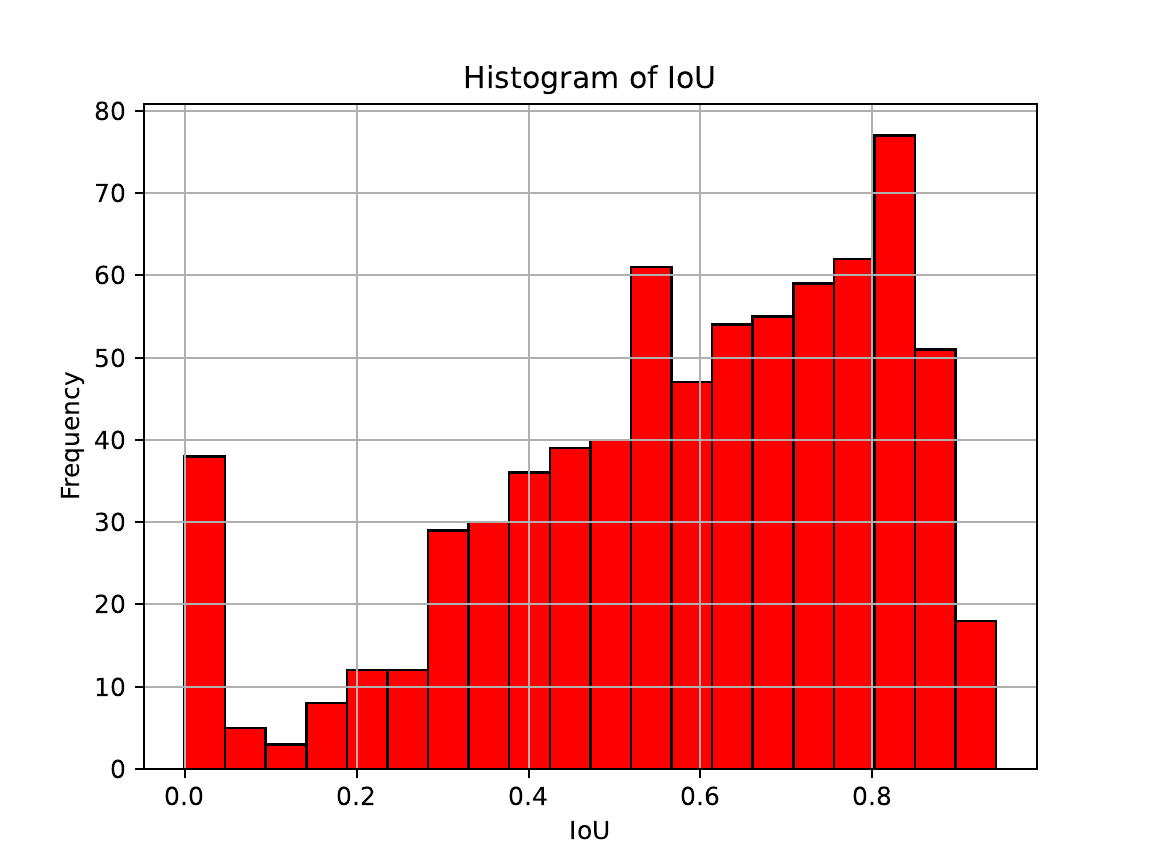
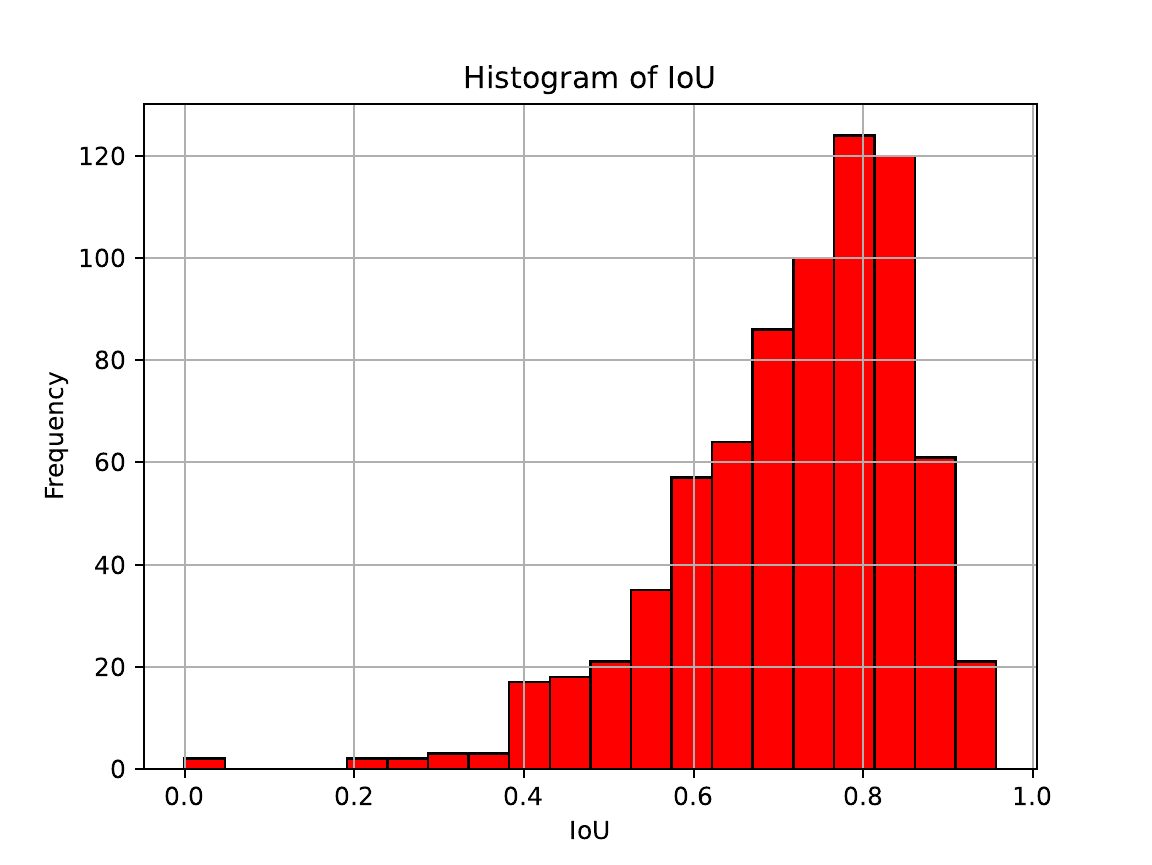
Le U-Net produit des masques plus précis et plus stables, notamment lorsque les couleurs du premier plan et du fond sont difficiles à séparer. La distribution d’IoU de GrabCut possède une longue queue vers les valeurs faibles : son modèle colorimétrique devient ambigu lorsque l’animal et le décor ont des distributions similaires. Le réseau peut au contraire exploiter la texture, les contours et un contexte spatial plus large.
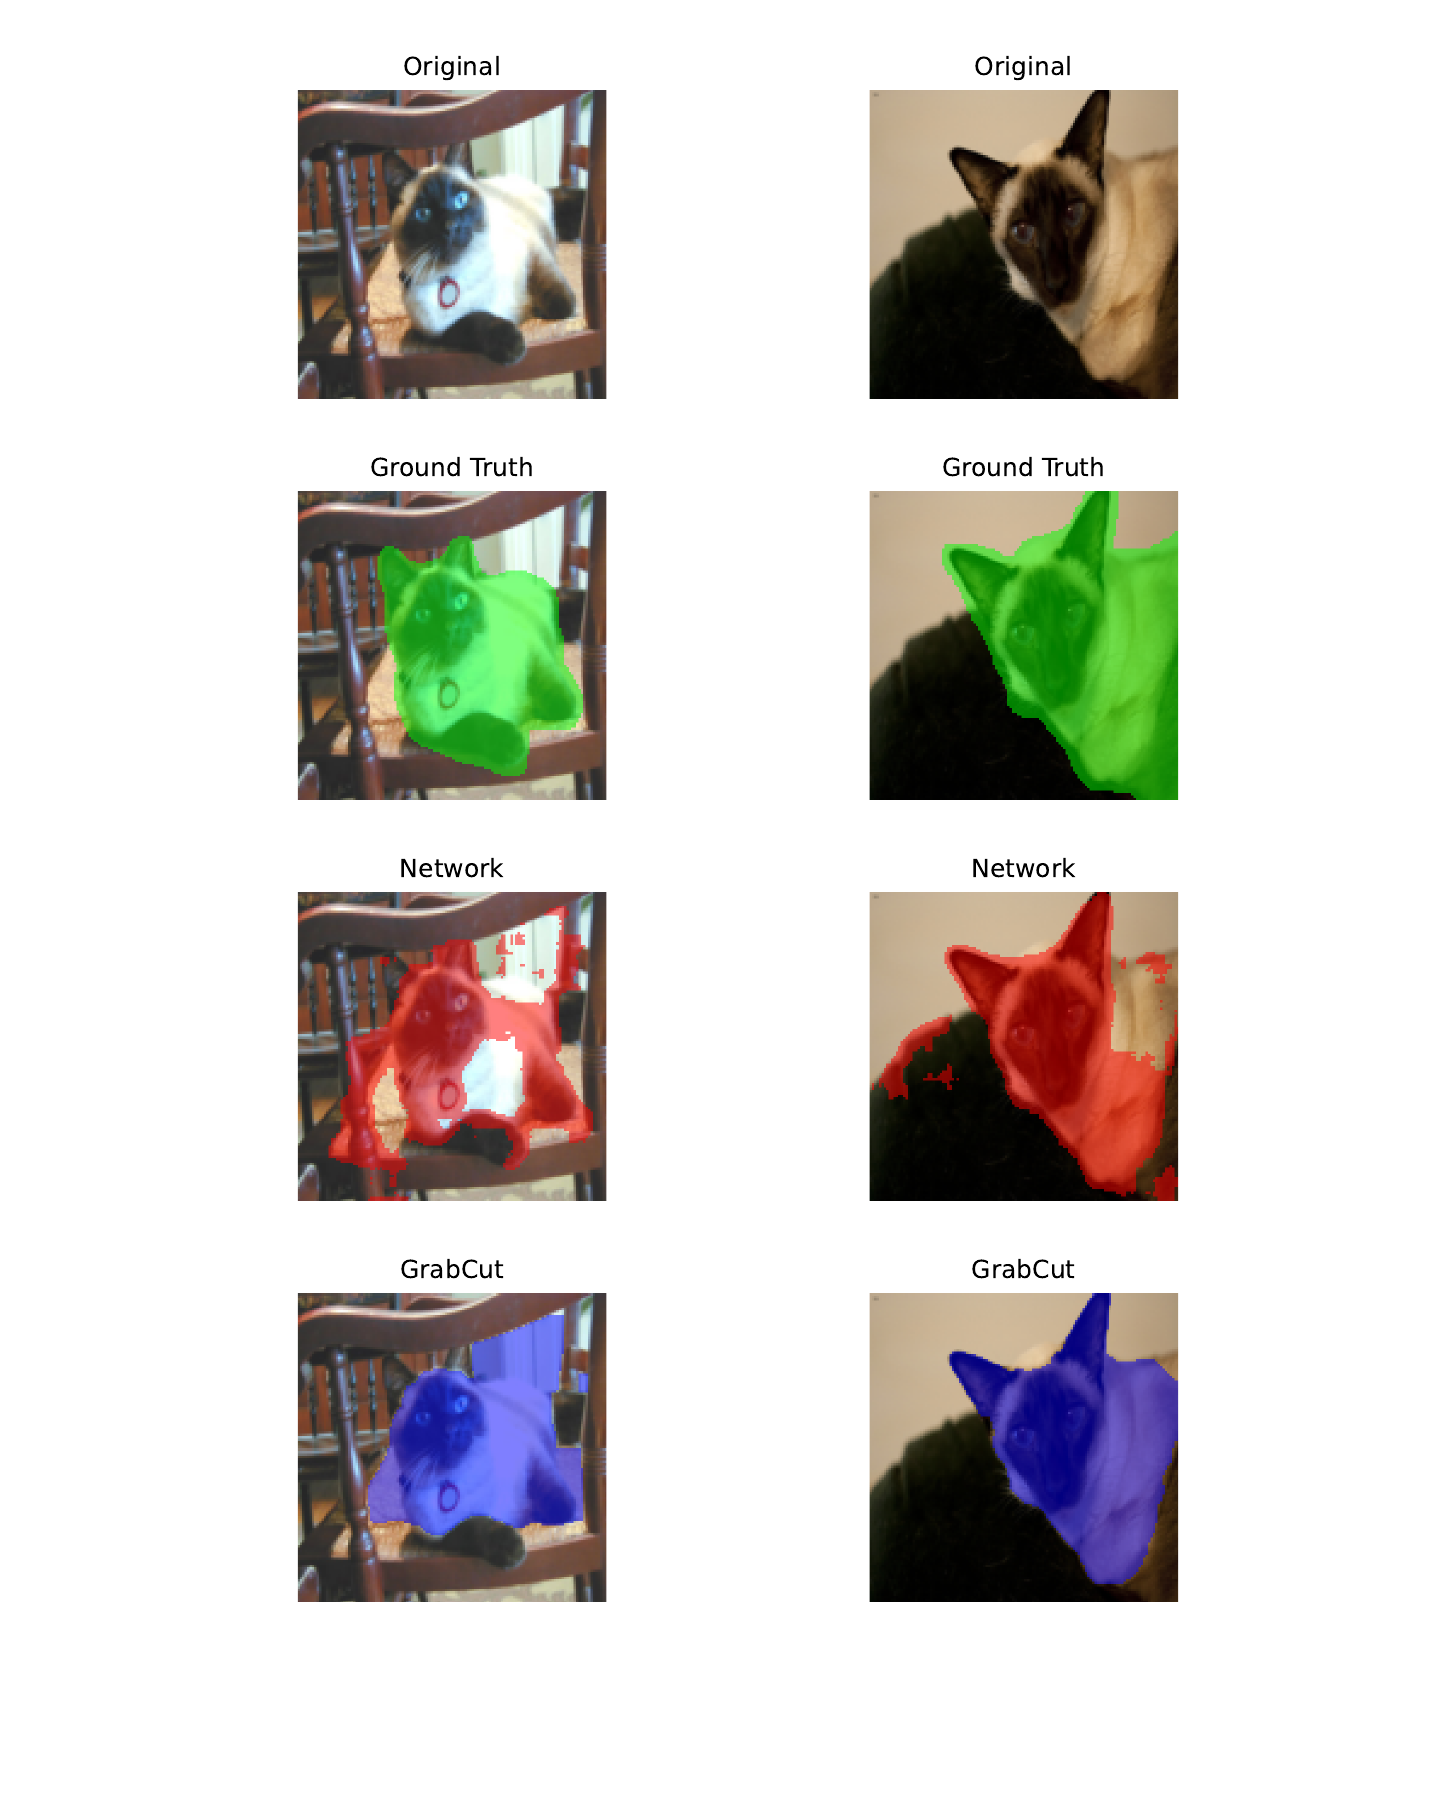
Deux images, quatre niveaux de lecture
De haut en bas : image originale, vérité terrain, prédiction du U-Net et résultat de GrabCut. Le réseau récupère mieux la forme globale, mais ses frontières restent imparfaites à 128 × 128.
Le véritable compromis d’ingénierie
Ce résultat ne signifie pas que la segmentation classique est obsolète. GrabCut est simple à déployer, ne demande aucun jeu d’entraînement et ne possède aucun poids appris à stocker. Pour un système embarqué ou un outil interactif ponctuel, ces propriétés peuvent compter davantage que la métrique moyenne. Le U-Net devient préférable lorsque la qualité et la régularité de la segmentation justifient le coût supplémentaire d’entraînement et d’inférence.
| Propriété | GrabCut | U-Net léger |
|---|---|---|
| Information préalable | Boîte par image | Jeu d’entraînement annoté |
| Optimisation | À chaque inférence | Pendant l’entraînement |
| État appris | GMM propres à l’image | Poids convolutionnels partagés |
| Signal principal | Couleur et régularité locale | Caractéristiques multi-échelles |
| Déploiement | Peu de stockage, compatible CPU | Modèle et calcul tensoriel |
| Échec typique | Couleurs premier plan/fond similaires | Décalage de distribution |
Pipeline reproductible
python methods/deep.py --mode train --plot
python methods/deep.py --mode predict
python methods/classical.py --all
python evaluation/evaluate.py
Les masques des deux méthodes sont sauvegardés avant l’évaluation ; le calcul des métriques reste ainsi indépendant de l’entraînement et de l’inférence.
Limites de l’étude
La comparaison porte sur des masques binaires à faible résolution, une seule partition du jeu de données et un réseau compact entraîné sans augmentation de données. GrabCut reçoit également une boîte englobante calculée depuis l’annotation ; son évaluation suppose donc une source externe de localisation de l’objet. Ces choix ont rendu l’expérience réalisable sur du matériel limité, mais ils définissent aussi la portée de ses conclusions.
Références
- C. Rother, V. Kolmogorov et A. Blake, « GrabCut: Interactive Foreground Extraction Using Iterated Graph Cuts », ACM Transactions on Graphics, vol. 23, nº 3, p. 309–314, 2004.
- O. Ronneberger, P. Fischer et T. Brox, « U-Net: Convolutional Networks for Biomedical Image Segmentation », dans Medical Image Computing and Computer-Assisted Intervention, p. 234–241, 2015.
- O. M. Parkhi, A. Vedaldi, A. Zisserman et C. V. Jawahar, « Cats and Dogs », dans IEEE Conference on Computer Vision and Pattern Recognition, p. 3498–3505, 2012.
- D. P. Kingma et J. Ba, « Adam: A Method for Stochastic Optimization », dans International Conference on Learning Representations, 2015.
- A. Paszke et al., « PyTorch: An Imperative Style, High-Performance Deep Learning Library », dans Advances in Neural Information Processing Systems 32, 2019.
Commentaires et suggestions
Questions, corrections et suggestions sont les bienvenues. Je lis chaque message avant sa publication.
Chargement des commentaires…